谷歌 Gemini 4 Argon 发布:单次输出 100 万 token,$2/$10 半价硬刚 Opus 5.5
谷歌 Gemini 4 Argon被传支持单次输出100万 token,并以每百万 token 输入2美元、输出10美元的价格挑战 Opus 5.5。本文拆解长输出限制、计费口径、质量风险、API接入与实测方法。
更新日期:2026年10月1日
“单次输出100万 token、输入 $2、输出 $10”是 Gemini 4 Argon 传播最广的规格组合。它如果被 Google 官方模型页确认,将改变长报告、代码生成和批量 Agent 的成本模型;但输出上限、价格和 Opus 5.5 对比目前都应视为待核验信息。本文给出一套可执行的核对和评测方法,避免把营销口径直接当成生产承诺。开始核对前,建议同时打开 Google Gemini API 模型文档、官方价格页和 API 参考。
一、100万 token 输出到底意味着什么?
上下文窗口和最大输出是两个概念。上下文窗口决定一次请求能读多少内容,最大输出决定模型最多能生成多少内容;即使 Argon 宣称单次输出100万 token,也可能受到总上下文、响应超时、流式连接、账户配额和安全策略限制。
100万 token 约等于数十万字中文或一套大型代码归档,但不代表一次生成整本书就能保持一致质量。越长的响应越容易出现重复、格式漂移、引用失真和后半段质量下降。生产系统更适合把长任务拆成章节、函数或可校验的 JSON 块。关于长上下文资料组织和模型发布时间,可交叉阅读本站的 Gemini 模型发布时间时间线。
二、$2/$10应该怎样读?
常见的价格写法是“输入 $2 / 百万 token,输出 $10 / 百万 token”。它可能只适用于标准短上下文档位,缓存输入、长上下文、Batch、图片视频折算和工具调用另有价格。
| 项目 | 需要从官方价格页确认的内容 |
|---|---|
| 输入 $2 | 是否为标准文本输入,是否含缓存读取 |
| 输出 $10 | 是否包含推理 token,是否存在不同 thinking 档位 |
| 100万输出 | 是硬上限还是实验性配额,是否按账户开放 |
| 长上下文 | 超过某一输入长度后是否加价 |
| 服务等级 | Batch、Flex、实时 API 的折扣和延迟差异 |
把 Argon 与 Opus 5.5 进行价格比较时,应统一单位、输入输出比例和缓存命中率。只比较“每百万输出 token”会得出误导结论。
三、长输出最适合哪些任务?
1. 大型代码迁移
Argon可以尝试一次规划多个模块的迁移方案,但不要让模型直接输出无法审查的百万 token 补丁。更可靠的流程是先生成文件清单和依赖图,再按模块输出补丁,最后运行测试和静态检查。
2. 长篇研究与资料整合
面对大量论文、会议记录和网页摘录,模型可以先做分层摘要,再生成带来源定位的综合报告。每个结论都应保留原文片段、文档 ID 和页码,方便人工复核。Google 的 长上下文与文档处理说明可用来核对输入限制;本站的 Gemini 3.1 Pro 深度评测可作为中文长文档评测的补充阅读。
3. 数据与内容批处理
批量分类、字段抽取和格式转换通常不需要百万 token 连续输出。将每条结果限制为结构化 JSON,配合 Batch API,往往比一次性生成超长自然语言更稳定。
四、与 Opus 5.5 对比,应该看哪些指标?
标题里的“硬刚”属于传播语言,工程决策要看可重复数据。建议建立如下评测表:
| 指标 | 测量方法 | 为什么重要 |
|---|---|---|
| 首 token 延迟 | 发送请求到首个流式片段的时间 | 决定交互体验 |
| 完成率 | 任务一次通过验收的比例 | 比单次回答漂亮更重要 |
| 长度稳定性 | 生成20万、50万 token后的错误率 | 检查长输出退化 |
| 事实与引用 | 抽样核对来源和数字 | 防止长文幻觉累积 |
| 单位交付成本 | 总费用/通过验收的任务数 | 直接关联预算 |
| 重试率 | 超时、截断、格式错误次数 | 反映真实运营成本 |
测试时固定提示词、工具、采样参数和最大输出,分别跑短任务与长任务。Opus 5.5若在短任务更稳,而 Argon 在长文档成本更低,系统可以按任务路由。
软件工程场景还可以参考 DeepSWE v1.1 这类长周期编程评测。下图只反映特定测试集和评测方法下的结果,不能替代对真实代码库、依赖环境和测试流程的验证。
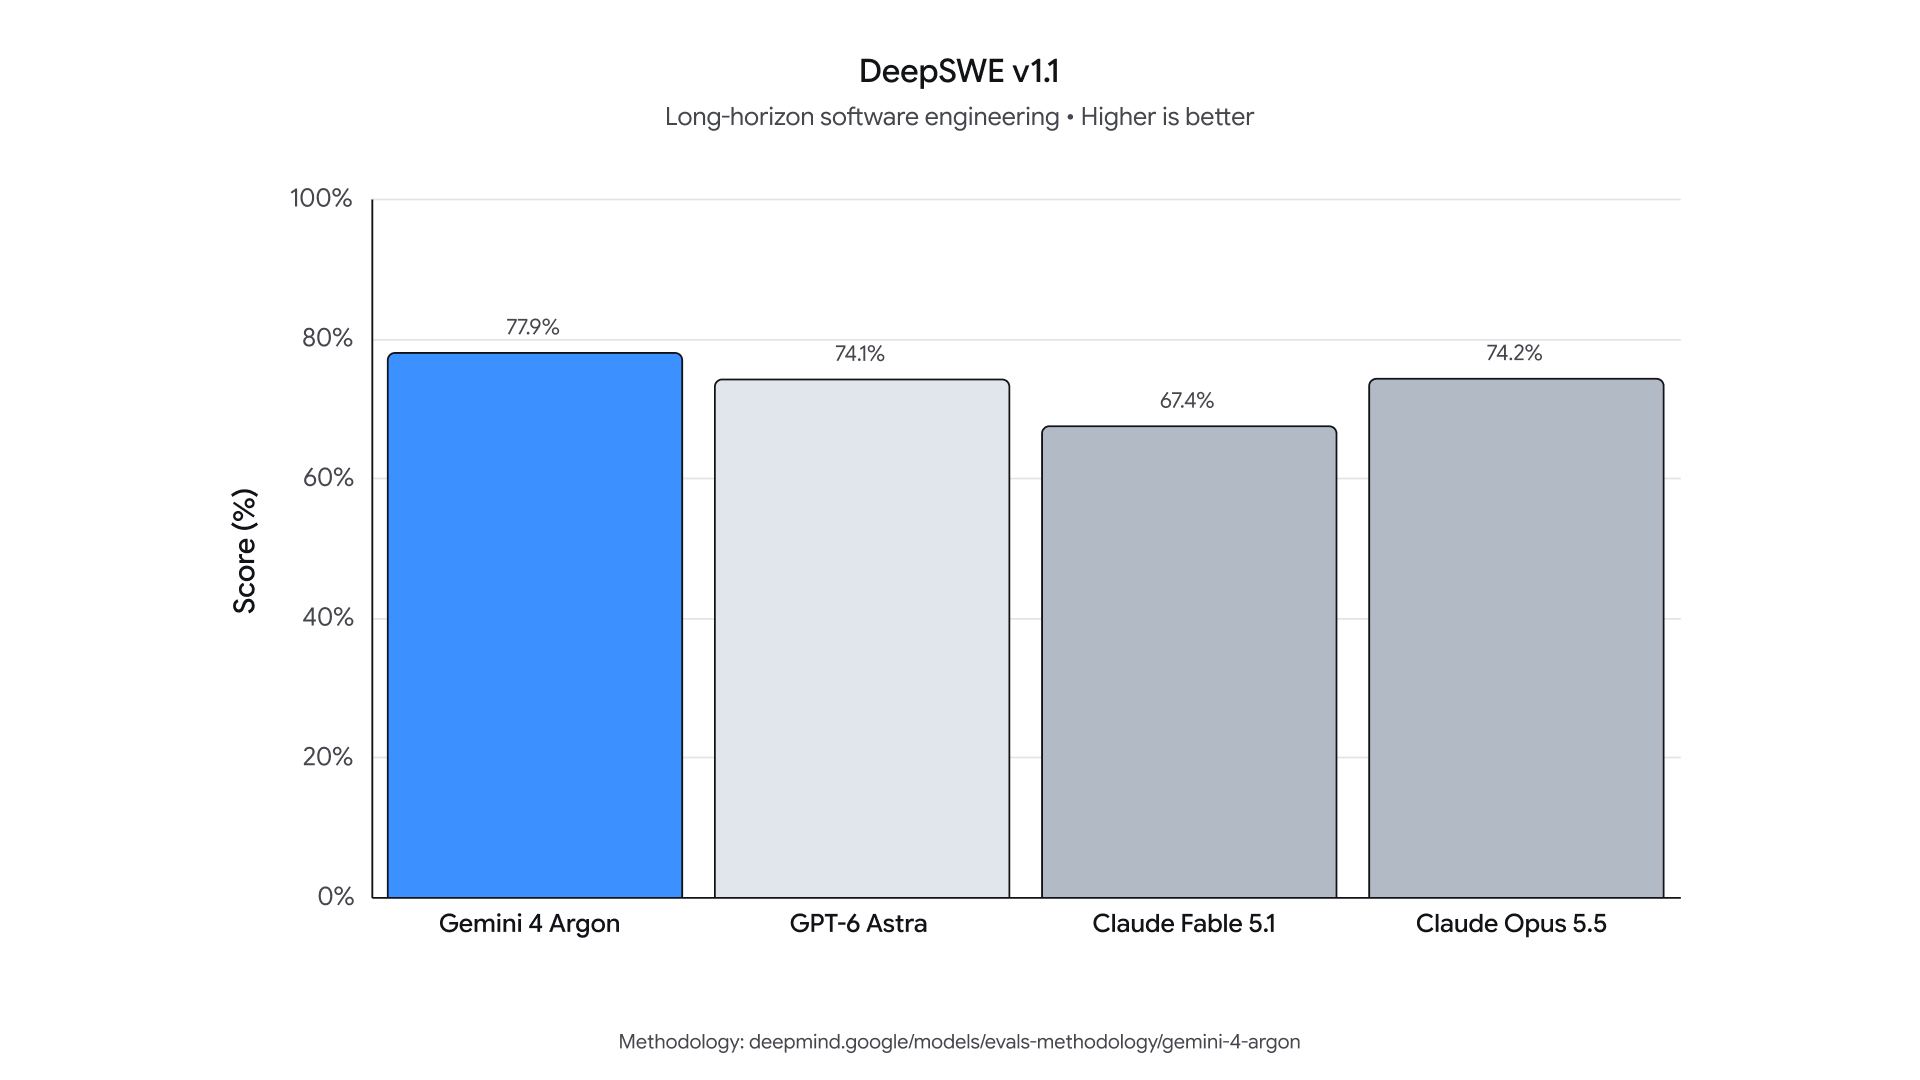
图:DeepSWE v1.1 长周期软件工程对比。图中结果用于说明评测维度,实际迁移仍需记录补丁通过率、回归测试和人工返工成本。
五、API接入与长输出工程实践
在 Google AI Studio确认模型可用后,再阅读 Gemini API 文档、文本生成指南和 流式响应说明。本站的 Gemini 官网开发者指南介绍了 API Key、AI Studio 和 System Instructions 的基本流程。接入时建议:
- 设置明确的
maxOutputTokens,不要默认请求百万级输出。 - 使用流式响应并记录断线位置,支持幂等续写。
- 要求模型按章节或 JSONL 输出,每个块附带序号和校验字段。
- 对超时、截断、空响应和工具失败设置指数退避,但限制最大重试次数。
- 将长任务拆成“规划—生成—校验—合并”四步,并保存中间产物。
from google import genai

client = genai.Client()
response = client.models.generate_content(
    model="gemini-4-argon",
    contents="按 JSONL 分块输出这份代码库的迁移计划,每块不超过 2000 token。",
    config={"max_output_tokens": 12000},
)
print(response.text)
模型 ID 只是示例,必须替换成官方控制台实际显示的 ID。API Key 只放在服务端,不要提交到仓库。若要比较函数调用和工具编排,可进一步参考本站的 Gemini 3.1 API 工具组合文章。
六、100万输出的风险与边界
- 质量风险:输出越长,重复、前后矛盾和格式漂移概率越高;
- 成本风险:一次失控生成可能快速消耗预算,应设置项目级配额和告警;
- 延迟风险:百万 token 响应可能超过浏览器、网关或函数运行时的超时限制;
- 数据风险:上传内部代码、客户资料或会议录音前,需确认 Google 服务条款、数据保留和组织合规要求;
- 供应商风险:预览模型、地区配额和价格可能随时变化,生产系统必须保留降级模型。
涉及中国大陆用户时,请遵守当地法律法规与平台条款。第三方 Gemini 中文站或聚合 API 不等同于 Google 官方服务,使用前核对数据是否转交第三方、模型是否真实映射以及退款规则。
常见问题
Gemini 4 Argon真的能单次输出100万 token吗?
目前应以 Google 官方模型规格和你自己的项目配额为准。即便规格写有100万,也可能只对特定 API、地区或预览账号开放。
$2/$10是最终价格吗?
不能直接下结论。请确认输入与输出单位、缓存、长上下文、批处理、工具调用和税费口径,并以 Google 官方价格页为准。价格页更新后,旧截图不再可靠。
Argon会全面超过 Opus 5.5吗?
没有任何单一跑分能证明全面领先。用自己的中文、代码、长文档和 Agent 任务做 A/B 测试,比较通过任务的总成本。
普通用户需要百万 token 输出吗?
大多数问答、翻译和摘要不需要。普通用户更应关注响应稳定、引用准确和实际额度;百万级输出主要面向大型代码、研究资料和批处理管线。
结语
Gemini 4 Argon的 $2/$10 定价和百万 token 输出如果最终得到官方确认,确实会给长上下文应用带来新的成本选项。但“便宜”和“能输出很长”只是起点,真正的竞争力仍取决于任务完成率、长响应质量、配额和可控性。先在 AI Studio 做小规模实测,再对照本站的 Gemini API 开发指南和 Google 官方文档,决定是否与 Opus 5.5 并行或迁移。