Gemini 4 Argon发布:谷歌7个月追平Astra,还便宜六成
Gemini 4 Argon被传为谷歌面向复杂推理与智能体任务的新旗舰。本文梳理其与Astra的发布时间差、上下文、推理、API价格和适用场景,区分已证实信息与待核实参数,帮助开发者制定迁移和成本测试计划。
更新日期:2026年10月1日
如果你最近看到“Gemini 4 Argon发布”的消息,最值得先看的是两个数字:谷歌据称在上一代旗舰发布约7个月后完成追赶,API综合价格比同级 Astra 低约六成。这类说法很适合做标题,却不能直接替代官方模型页。本文按“目前流传的发布信息—可验证规格—成本模型—迁移方法”展开,所有价格、开放范围和评测结果都应以 Google AI for Developers、Gemini API 参考文档 与 Gemini API 价格页的实时内容为准。想先了解 API Key、AI Studio 和系统指令,可阅读本站的 Gemini 官网开发者指南。
图:Gemini 4 Argon 发布主视觉图。具体型号、开放范围和参数仍应以 Google 官方模型目录为准。
一、Gemini 4 Argon是什么?
Gemini 4 Argon可理解为面向高难度任务的 Gemini 4 旗舰型号:重点不是普通聊天速度,而是长上下文推理、代码库级分析、工具调用和多轮智能体执行。所谓“7个月追平Astra”,通常是媒体把两款模型的发布时间和公开评测放在同一张时间线上比较,并不代表所有任务、所有模式都达成一比一领先。
目前更稳妥的判断方式是检查三项信息。Google 的 Gemini 模型文档和 Vertex AI 生成式 AI 文档应作为规格核对入口:
- Google 是否在模型目录中公开精确模型 ID、知识截止日期和上下文窗口;
- AI Studio、Vertex AI 或 Gemini API 项目是否能实际选择 Argon;
- 价格页是否同时列出标准、缓存、批处理和长上下文费率。
如果只有社交媒体截图或第三方聚合站的模型列表,应标记为“传闻/预告”,不要据此采购或改写生产代码。
二、为什么说“7个月追平Astra”?
这句话的核心是产品节奏,而不是简单的日期相减。假设 Astra 在2026年初成为复杂 Agent 任务的参照物,Argon在约7个月后发布,Google 需要在较短周期内补齐以下能力:
| 能力维度 | 用户真正要比较的指标 | 评测时要留意 |
|---|---|---|
| 复杂推理 | 多步任务的最终正确率 | 是否允许工具、是否使用最高思考档位 |
| 代码能力 | 修复测试、跨文件重构成功率 | 是否在完整仓库和真实依赖中运行 |
| Agent 执行 | 任务完成率、重试次数 | 失败后能否恢复,而非只看首轮答案 |
| 长上下文 | 召回率和引用准确度 | 输入很长时是否触发额外费率 |
| 交互速度 | 首 token 延迟、输出速度 | 地区、并发和流式设置会影响结果 |
因此,“追平”更像一个综合结论。开发团队应把它拆成自己的验收标准,例如代码任务通过率、工具调用成功率、人工返工分钟数和每个成功任务的美元成本。
下面的 AutomationBench 图表可作为企业工作流自动化的观察样例。它展示的是特定评测方法下的分数,不等于所有办公流程中的实际成功率;正式比较时仍应使用自己的任务集复测。
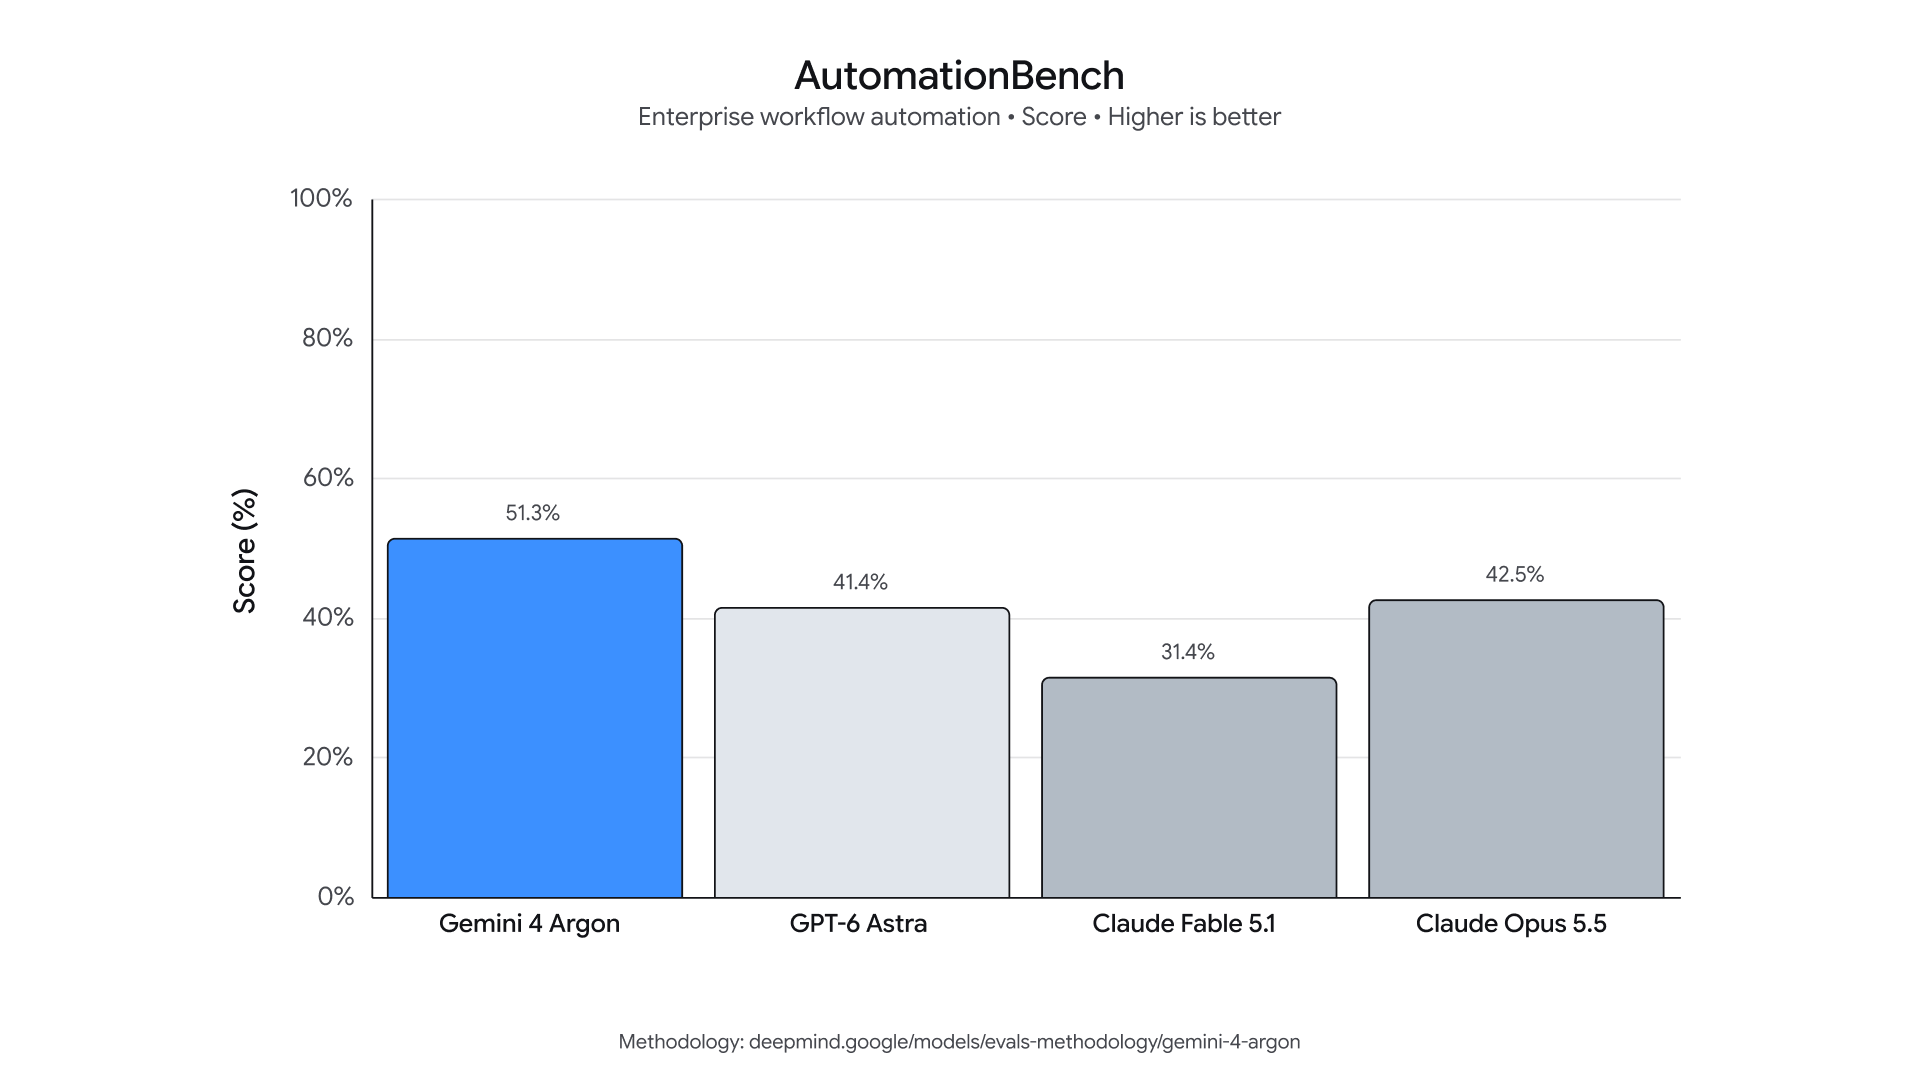
图:AutomationBench 企业工作流自动化对比。Higher is better;评测口径和模型版本变化时,分数不可直接横向复用。
三、Argon可能带来的关键升级
1. 长上下文从“能放下”变成“找得到”
百万级上下文只有在模型能稳定定位信息时才有价值。测试 Argon 时,可以准备一套包含需求、接口文档、日志和多版本代码的资料,要求它给出带文件名和行号的结论,再用脚本核对引用。比单纯上传一份长 PDF 更能看出上下文检索质量。本站的 Gemini 3 Pro 编程能力实测也提供了代码生成、调试和 API 集成的评测思路,可作为测试集设计参考。
2. 推理档位与成本联动
旗舰模型通常会提供不同 thinking effort。低档位适合分类、改写和结构化抽取;高档位用于调试、数学推导和跨工具规划。不要把所有请求都固定到最高档位,否则“便宜六成”可能会被更长输出、重试和工具调用抵消。
3. 原生多模态与工具调用
Gemini 系列的优势往往来自文本、图片、音频、视频和代码的组合输入。对 Argon 的验证应覆盖表格截图、产品录屏、会议音频和 API schema,而不是只做纯文本问答。Google 的 多模态概念文档可用于确认输入类型;本站的 Gemini 3.1 API 更新解析则整理了函数调用、工具组合和接地能力。需要付款、发送邮件、删除数据的工具仍应保留人工确认。
四、价格便宜六成,账单会怎样变化?
“便宜六成”一般指同等输入/输出 Token 下,Argon的标价约为 Astra 的40%。真实账单还取决于缓存命中率、长上下文倍率、批处理折扣、图片或视频折算 Token,以及失败重试。建议用以下公式估算单任务成本:
总成本 = 输入 Token × 输入单价 + 缓存 Token × 缓存单价 + 输出 Token × 输出单价 + 工具与存储费用
| 费用项 | 迁移前必须确认 |
|---|---|
| 输入 | 普通输入与超过长上下文门槛是否分档 |
| 输出 | 最大输出限制、推理隐藏 Token 是否计费 |
| 缓存 | 缓存有效期、写入和读取分别如何收费 |
| 工具 | 搜索、代码执行、文件检索是否另计费 |
| 批处理 | Batch/Flex 是否牺牲延迟换折扣 |
五、Argon与Astra怎么选?
| 场景 | 更适合先测试 Argon | 更适合保留 Astra |
|---|---|---|
| 长文档问答 | 需要大量 Gemini 原生多模态资料 | 已有 Astra 的稳定引用链路 |
| 软件工程 | 追求较低单次任务成本 | 依赖现有 Astra 工具生态 |
| 批量抽取 | 请求量大、延迟要求适中 | 需要更成熟的企业 SLA |
| 高风险决策 | 先做影子流量验证 | 已通过合规和安全评审 |
不要只看排行榜。用过去一个月的匿名任务做 A/B:每个模型至少跑50个样本,记录正确率、延迟、Token、重试、拒答和人工修改时间。最终比较“每个可交付结果的成本”,而不是每百万 Token 的漂亮数字。
六、开发者迁移清单
- 在 AI Studio 或 Vertex AI 建立独立测试项目,确认 Argon 的精确模型 ID和区域可用性。
- 固定同一套 system prompt、工具 schema、温度和输出格式,避免比较时变量过多。
- 为长文档、代码修复、多模态理解和工具编排分别建立评测集。
- 记录每次请求的输入/输出 Token、缓存命中、耗时和失败原因。
- 先用 5%—10% 影子流量观察,再逐步扩大;保留 Astra 作为可回滚模型。
API Key 应放在服务端密钥管理系统中,不要写入前端、公开仓库或日志。涉及中国大陆用户时,还要遵守当地法律法规、Google 服务条款和所在组织的数据合规要求;第三方中文聚合平台不是 Google 官方入口,隐私和计费规则需单独核对。
常见问题
Gemini 4 Argon已经全面开放了吗?
不能仅凭发布标题判断。请以 AI Studio、Vertex AI 控制台和官方模型目录中你自己的项目权限为准。
“便宜六成”是输入和输出都便宜六成吗?
通常只是对比口径下的综合或标价估算。缓存、长上下文、Batch、工具和多模态输入可能使用不同费率,必须逐项核算。
Argon一定比Astra更强吗?
不一定。模型在代码、中文写作、视觉理解和工具调用上的优势可能不同,建议用自己的任务集做 A/B 测试。
个人用户在哪里体验?
优先检查 Gemini 官方入口、Google AI Studio和 AI Studio 的模型选择器。若第三方平台声称“独家 Argon”,应核对模型 ID、隐私政策、价格和退款规则;国内访问路径可参考本站的 Gemini 国内使用方法整理,但第三方服务不等于 Google 官方服务。
结语
Gemini 4 Argon的真正价值,需要由“7个月追平”和“便宜六成”两个标题数字,落到可复现的任务成功率与单位交付成本上。先核对 Google 官方模型目录和 官方价格页,再用真实数据做小流量迁移;结论成立后,Argon才值得成为长期的 Gemini 主力模型。